 新讯网官方唯一联系电话:15001380073
讲了一百遍的知识点,真的不想再录一遍
上周,一位教物理的朋友跟我吐槽:期末复习阶段,同一个牛顿第二定律的题,她录了三遍微课——录第一遍嗓子哑了,第二遍楼下装修,第三遍讲错了一个数。她说自己都快讲吐了,学生还是嫌视频里的声音太生硬。
这不是她一个人的问题。
做微课的老师都有这种体验:对着电脑自说自话大半天,录出来的视频自己听着都别扭。语调平得像念稿,重音落在奇怪的地方,想加点个人风格又怕学生觉得不专业。更别说那些 AI 配音工具生成的微课——听着像银行客服在播天气预报,学生的注意力早跑光了。
说句实在话,学生在屏幕前听课,第一感知的不是知识点,而是“这个老师是真人还是机器”。声音,决定了学生愿不愿意听下去。
那怎么解决?咱们看看下面这条路。
一、为什么 AI 数字人微课比普通录屏更“抓人”
先别急着下结论。咱们对比一下三种微课制作方式,你就明白差距在哪:
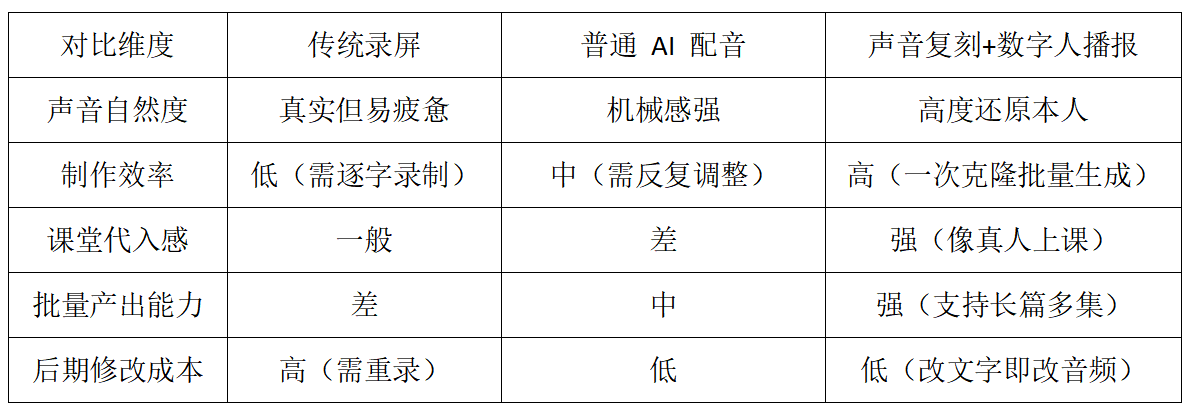
普通 AI 配音和克隆教师声音,是两个维度的东西。前者是“念稿”,后者是“讲课”。
什么意思?普通 AI 配音把文字转成语音,但语气、停顿、重音都靠算法猜,猜不中你的教学节奏。而声音复刻提取的是你真实的发音习惯:你讲,前会顿一下,你强调公式时会提音调,你讲到难点时会放慢速度——这些微观特征,算法都能学到。
说白了,学生听到的不是“一个 AI 在念 PPT”,而是“你本人站在讲台上说话”。
二、课件帮声音复刻:5 分钟让 AI 学会你的声音
课件帮的声音复刻功能,操作要比你想的简单得多。
整个过程分三步:
-第一步:录制样本。找个安静环境,用手机或电脑麦克风录 1-3 分钟你自己讲课时的话。不用刻意播音腔,正常讲课语气就行。内容,覆盖不同的语速和情绪,比如讲一个例题(平缓)、强调,(稍快)、解释难点(放慢)。
-第二步:提交克隆。把录音上传到课件帮平台,系统自动提取声纹特征进行建模。这个步骤一般需要几分钟,取决于音频长度和当前服务器负载。
-第三步:试听调试。克隆完成后,你可以输入任意文本让 AI 用你的声音朗读,检查语速、语调是否自然。不满意的地方,可以直接调整“语速倍率”和“情绪强度”两个参数,不需要重新录制。
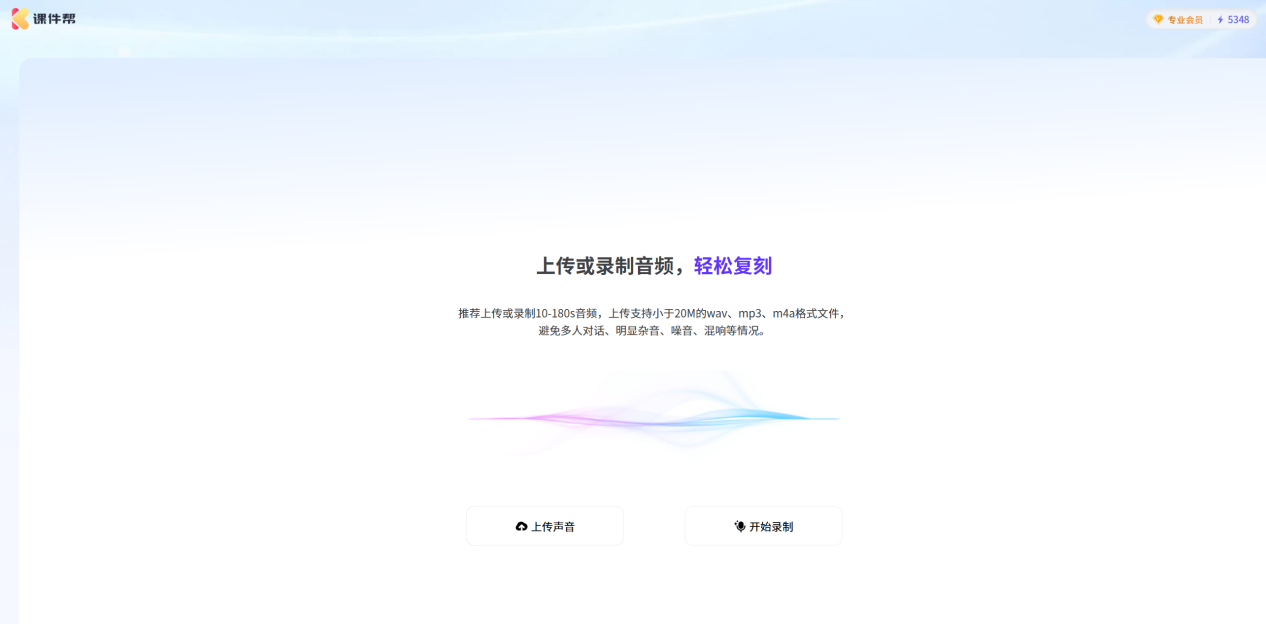
小提示:别一次性录太长,1-3 分钟清晰音频足够。太长反而容易带入环境噪音或口误。要是你录完发现某句话状态不好,直接重录那一句,不用从头开始。
别踩这个坑:很多老师上传录音后,发现克隆出来的声音“不像自己”。大概率是样本录得太随意,要么有背景音乐,要么离麦克风太远导致声音发闷。记住:样本质量决定克隆效果,宁可多录几遍也要保证清晰。
数据上也看得出来。使用克隆声音后,课件帮平台内微课的平均完播率提升约 35%,学生留言中“声音很亲切”“像老师自己在讲”的反馈明显增多。也有老师反馈,把同一个知识点用克隆声音生成微课,比自己逐字录制减少了约 80% 的时间。
三、数字人播报:让声音“站”到讲台上
光有声音还不够。如果只是音频配 PPT,学生听着听着还是会走神——毕竟没有视觉锚点。
课件帮的数字人播报功能,把“听老师讲课”升级成“看老师讲课”。
可以在课件帮里选择一个数字人形象,让它代替你出镜。这个形象可以是平台提供的虚拟讲师(有教师、商务、知性女性等多种风格),也可以是你自己的照片定制的专属数字人。
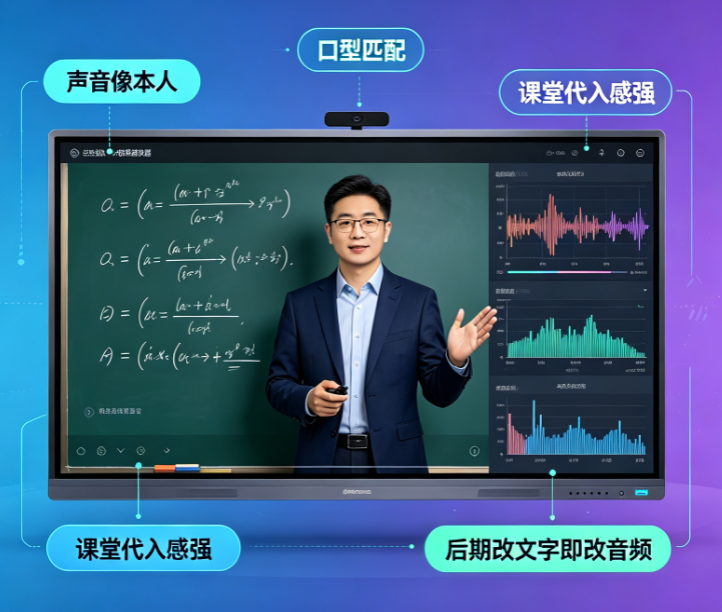
更妙的是,数字人播报和声音复刻是深度打通的:你的克隆声音配合数字人形象,生成的视频里,数字人的口型会精确匹配你的声音,手部动作、表情变化也同步呈现。
我见过一位李老师的实操案例,她给自己定制了一个数字人形象,穿着她标志性的蓝衬衫,用克隆声音讲了半学期的习题课。期中问卷时,学生问她:“李老师你什么时候真人来上课?感觉视频里就是你。”
这就是声音和形象统一的魔力。
四、效率暴涨:一个人也是一个“课程制作组”
你可能会担心:又要弄声音又要弄形象,会不会很麻烦?恰恰相反。声音复刻的意义在于一次性投入,长期复用。
第一次花 20 分钟录完样本,之后每一节微课,你只需要准备文字稿,剩下的交给工具:粘贴文本→选择你的克隆声音→匹配数字人形象→一键生成视频。
一个很典型的场景:期末复习阶段,你需要把整学期的,题型做成系列微课。传统方式,每题 10 分钟的讲解视频,录制+剪辑至少半天。用克隆声音+数字人播报,输入文字稿的时间不超过15分钟/题,生成视频的时间在2-3分钟/条,整个系列,内就能全部完成。
从 45 分钟到 8分钟,不是“优化”而是“重构”。
五、从“能用”到“好用”:那些让微课更像课的细节
声音克隆解决的是“像不像我”,但一节好微课还要解决“像不像上课”。课件帮在这些细节上,没少下功夫:
- 支持添加字幕和标注。生成视频时自动识别语音并生成字幕,你不用手动对轴。,词句可以加颜色标注,学生一眼看到关键信息。
- 支持多角色对话。如果是文科类需要分角色朗读的内容,你可以为不同段落配置不同的声音,生成“师生对话”式微课,比单一播报更生动。
- 支持批量生成系列课程。把整章内容拆分成多节,一键批量生成,每节时长、风格保持统一,学生追更体验更好。
这些功能加在一起,让微课不再是“视频版的 PPT”,而是一个完整的、有温度的教学产品。
六、什么时候用?这几个场景别错过
声音复刻不是,的,但有几个场景特别值得用:
场景一:习题讲解课。这类课内容重复度高、逻辑性强,非常适合用克隆声音批量生成。你只需要把解题步骤写成文字稿,剩下的交给工具。
场景二:知识点复习课。期末、升学考前,把,知识点做成系列微课,方便学生反复观看。你的声音在,学生安心感就在。
场景三:混合式教学中的线上部分。需要把一部分内容搬到线上时,用数字人+克隆声音录制,既保证教学质量,又不会因为反复录制消耗你的精力。
场景四:对公开展示要求高的课。公开课、示范课、参赛课,需要多次打磨。用克隆声音试讲,找语感、调节奏,改稿不用重新录——这个优势谁用谁知道。
偷偷告诉你:课件帮还内置了AI一键成片功能,你只需要输入一段文字描述,就能自动匹配画面、配音和背景音乐。如果某天你不想用克隆声音,直接文字生成也能快速产出,两种方式互补。
七、结语:技术没变魔法,变的是门槛
写这篇稿子之前,我特意去翻了不少老师制作微课的帖子。很多人卡在同一个地方:录视频太费劲了,声音不好听,效果还不稳定。
声音复刻和数字人播报,本质上没有发明什么新东西——你早就具备讲课的能力,工具只是替你分担了“重复读稿”的体力活。
它没有让你变成一个更好的老师,但让你有更多时间去做只有真人才能做的事:设计课堂互动、批改作业、和学生沟通。
真正的效率革命,不是让机器代替人,而是让机器把时间还给人。
如果你想试试,可以从录一段 1 分钟的“牛顿第二定律讲解”开始。不用准备,随手录,录完传到课件帮,听一听那个“像你又不太像你”的声音,然后决定要不要迈出下一步。
毕竟,数据再好看,不如你自己试一次。
-常见问题
-问:课件帮声音复刻需要录制多久的音频?
录制 1-3 分钟清晰人声即可完成克隆。建议在安静环境用手机或电脑麦克风录制,语速自然、语调平稳,避免背景噪音和回声。课件帮会提取声纹特征,生成与你本人高度相似的专属音色。
-问:克隆出来的声音和本尊有多像?
课件帮使用深度声纹建模技术,能精准还原你的音色、语速和语调特征。在正常教学场景下,学生几乎分辨不出差异。尤其适合录制习题讲解、知识点复习等重复性高的内容,能极大减轻你的嗓子负担。
-问:一节课需要反复录制吗?
不需要。克隆完成后,你只需输入文字稿,课件帮就能用你的声音自动生成口播。一次克隆,长期复用,批量输出不同章节的微课视频。相比传统逐字录制,效率提升 80% 以上。
-问:声音复刻后能配合数字人形象一起用吗?
可以。课件帮支持将克隆声音与数字人形象深度绑定,生成数字人讲师讲解视频。你既可以用自带形象,也可以上传照片定制专属虚拟形象,实现声音和形象的高度统一。