 新讯网官方唯一联系电话:15001380073
深夜十一点,你还在录微课吗?
上周跟一位教物理的老教师聊天,他苦笑着说:"一节15分钟的微课,我录了整整一个晚上。第3遍忘词,第7遍嘴瓢,第12遍楼下狗叫……,嗓子哑了,还是凑合用了第15遍。"
这话我太有共鸣了。录微课最折磨人的不是备课,而是反复录音。你花两小时写好讲稿,结果录音环节又搭进去三小时,还不算剪辑、降噪、重录的时间。
说句实在话,很多老师不是不想做微课,是真的被录音劝退了。但2026年,这个痛点正在被一项技术彻底解决——声音复刻。
一、声音复刻是什么?它和普通AI配音有什么本质区别?
先别急着划走,这不是什么科幻概念。声音复刻(Voice Cloning)就是让AI学会你的声音,然后用你的声音替你朗读任何文字。
你可能会问:"这不就是AI配音吗?我用过,机械感太重,学生一听就出戏。"
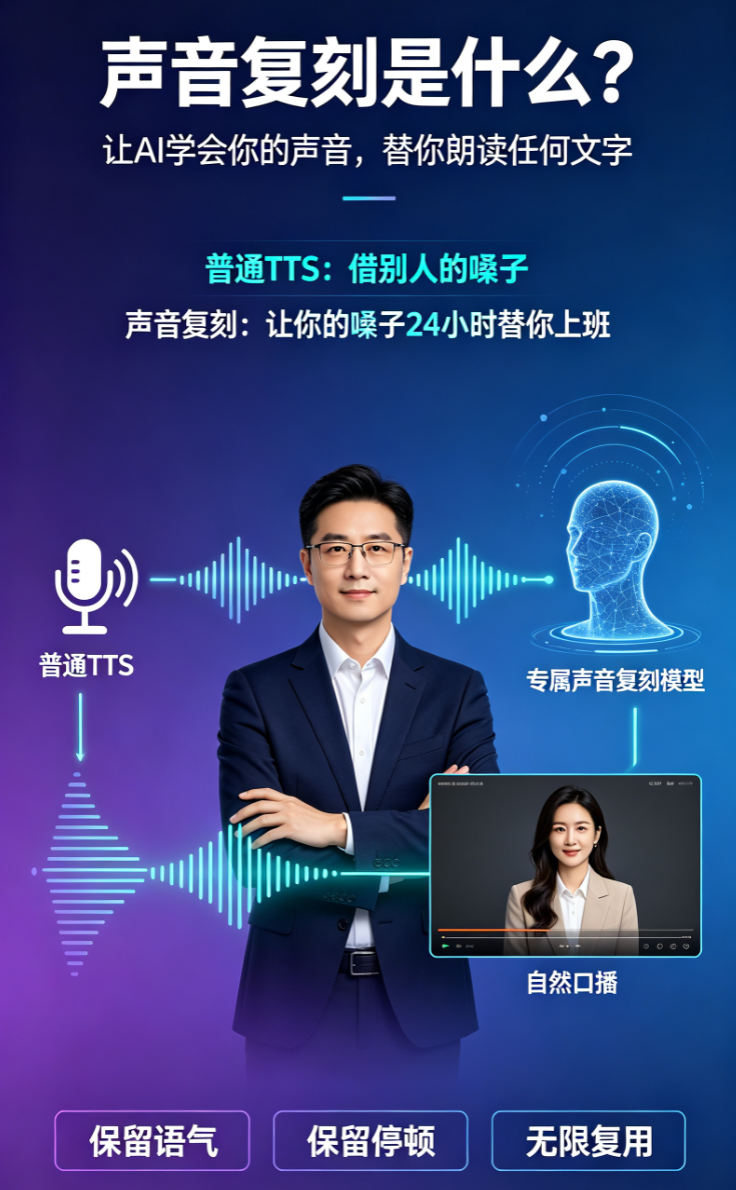
这就是关键区别了。传统TTS(文本转语音)用的是通用音色,比如"晓晓""云希",声音再好听也不是你的。而声音复刻是训练一个"声音分身",保留你说话的语气、停顿、甚至微微的方言口音。
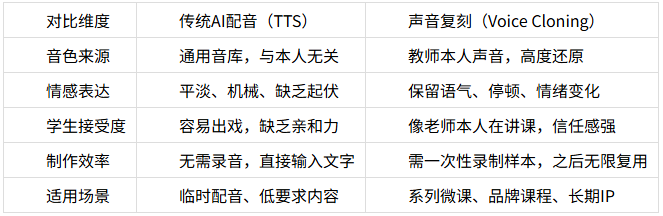
说白了,传统AI配音是"借别人的嗓子说话",声音复刻是"让你的嗓子24小时替你上班"。
二、2026年声音复刻技术演进:从实验室到教师桌面
前几年声音复刻还停留在技术演示阶段,需要专业录音棚和大量样本。但2026年的技术演进,让这项能力真正走到了教师身边。
第一个变化:样本量从小时级降到分钟级。过去克隆一个声音需要几小时的录音素材,现在只需10分钟左右的清晰语音样本,系统就能完成声音模型训练。这意味着你利用课间休息就能完成"声音建档"。
第二个变化:情感表达从"读字"到"说话"。早期的克隆声音只是模仿音色,听起来像机器人念稿。2026年的技术已经能捕捉语气词("嗯""对""大家注意")、疑问语气、重音强调,微课听起来就像老师真的在对着镜头讲课。
第三个变化:部署方式从云端到本地化。很多学校对数据安全有严格要求,不愿意把教师声音数据传到公网。课件帮支持私有化部署方案,声音模型可以存在学校本地服务器上,数据不出校门,安全合规有保障。
三、课件帮 声音复刻:教师批量生产微课的完整方案
聊完趋势,咱们说点实际的。课件帮的声音复刻功能,是专门为教师群体设计的,不是那种"技术很强但用不上"的演示品。
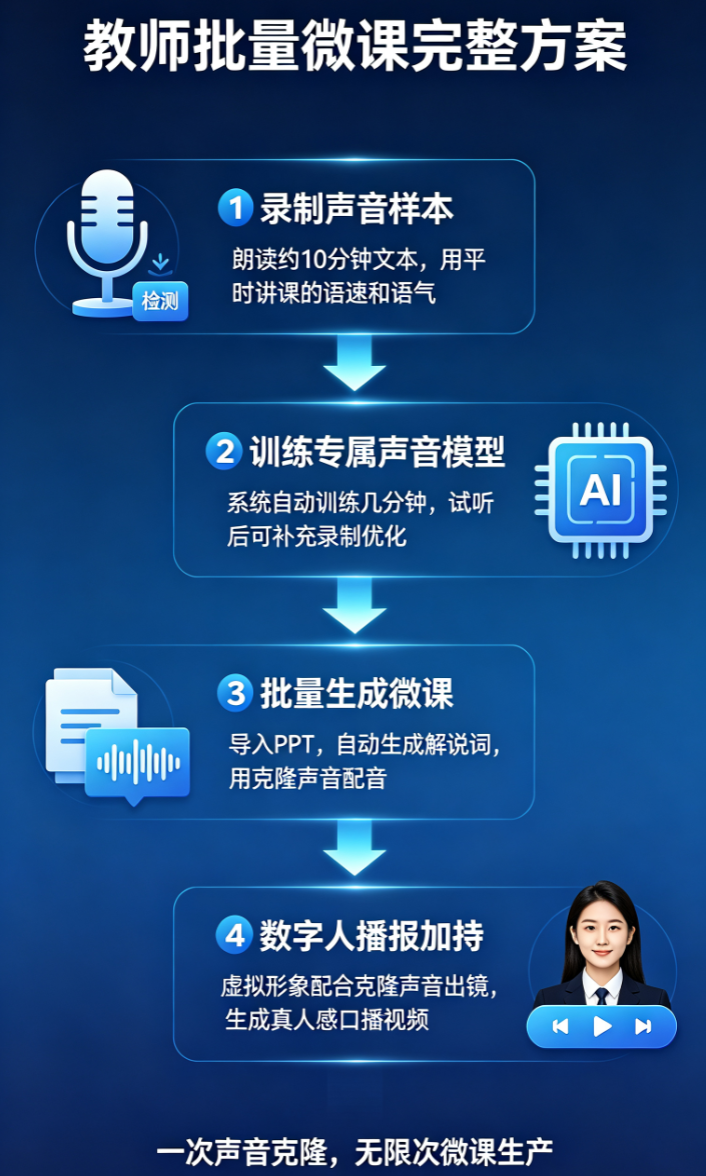
第一步:录制声音样本
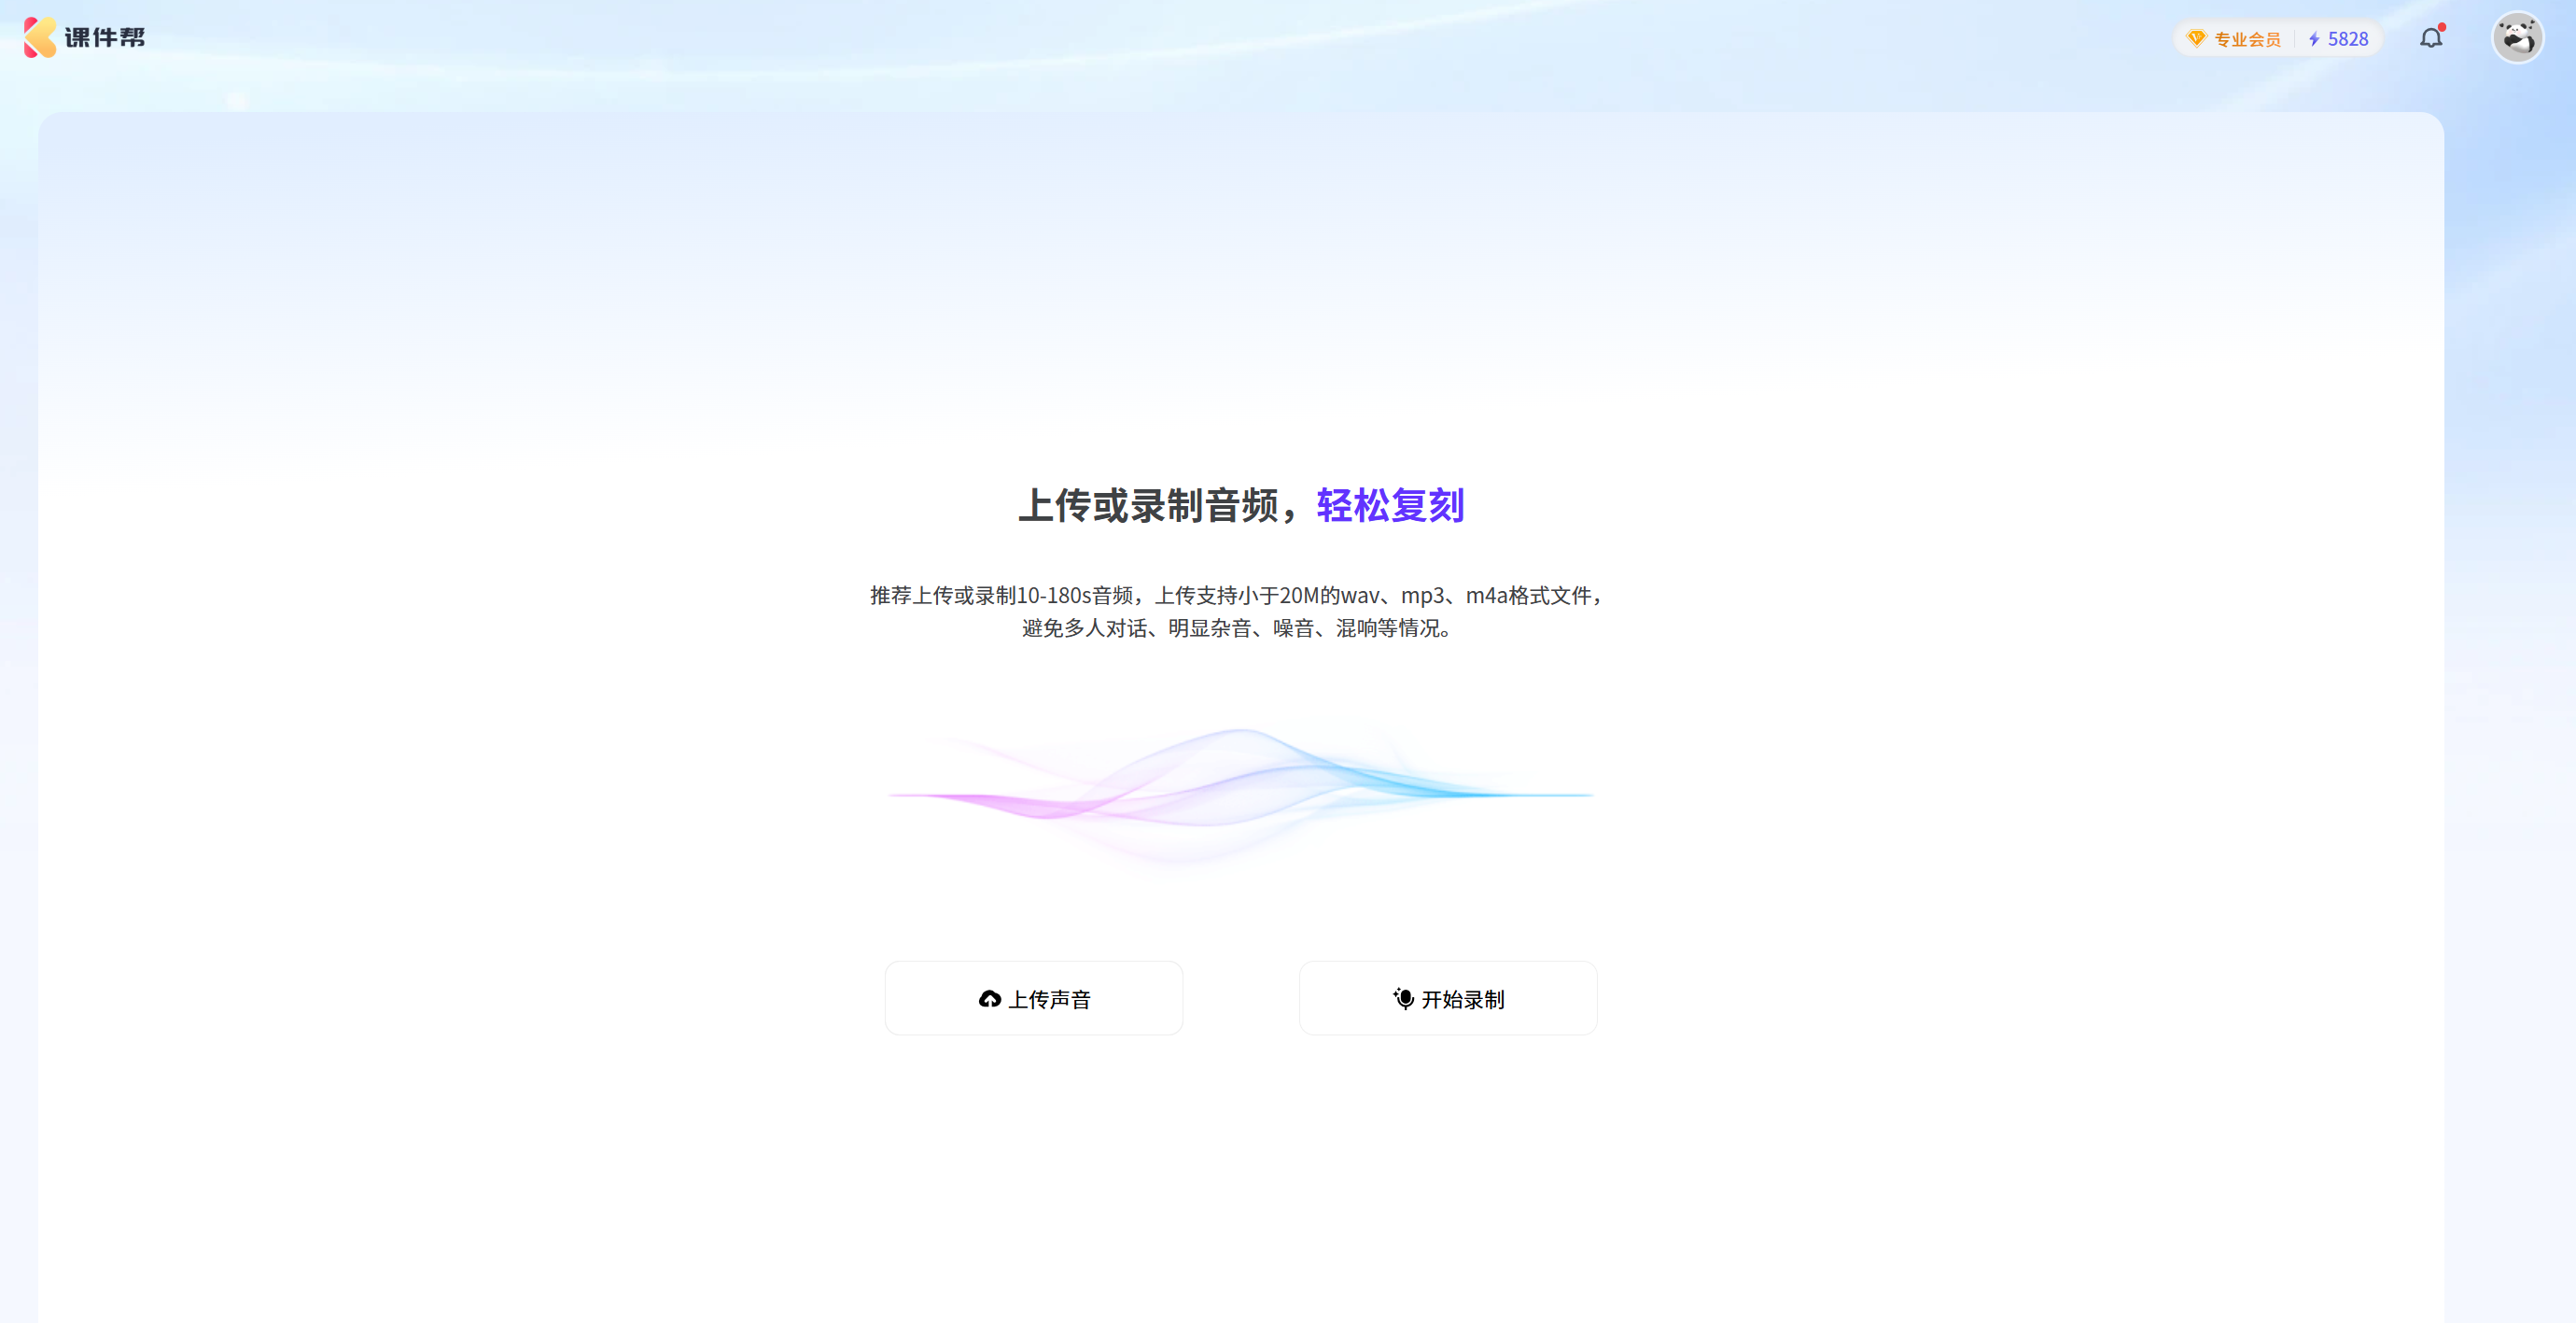
打开课件帮,找到"声音复刻"入口,系统会引导你朗读一段约10分钟的文本。别紧张,用你平时讲课的语速和语气就行,不用刻意字正腔圆。系统会自动检测声音质量,如果环境嘈杂会提醒你换地方。
第二步:训练专属声音模型
录制完成后,系统自动训练声音模型。这个过程大概需要几分钟,你完全可以去批个作业再回来。训练完成后,你可以试听几段样音,不满意可以补充录制,系统会增量优化。
第三步:用克隆声音批量生成微课
这是最爽的一步。你只需要把PPT导入课件帮,选择"PPT转视频",系统会自动为每一页生成解说词,并用你的克隆声音配音。转场动画、背景音乐、字幕全部自动加上,一节课的微课视频几分钟就出来了。
一次声音克隆,无限次微课生产。你今天录了10分钟样本,接下来一个学期都不用再碰麦克风。物理课、化学课、班会课,所有需要配音的内容,全部用你的声音批量输出。
第四步:数字人播报加持,让微课"看得见"
如果你觉得纯配音的微课还不够生动,课件帮还有数字人播报功能。你可以选择一个虚拟形象,让克隆声音配合数字人出镜,生成"真人感"口播视频。学生看到的不只是PPT翻页,而是一个"虚拟的你"在讲课,互动感和沉浸感完全不一样。
四、效率提升5倍?我们来算一笔账
前面提到"微课制作效率提升5倍以上",这不是拍脑袋说的。咱们算一笔时间账:
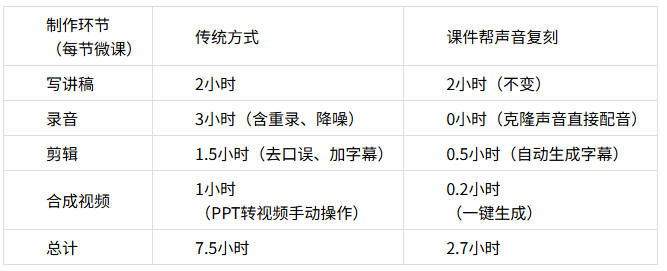
单节微课时间从7.5小时压缩到2.7小时,效率提升约64%。但真正的爆发在批量场景:传统方式录10节微课要75小时,而课件帮只需第一次花10分钟录样本,之后每节课约2.7小时,10节课总计约27小时。效率提升接近3倍,如果算上熟练操作和模板复用,5倍并非夸张。
五、声音复刻的避坑指南:这些事千万别做
技术虽好,但有些坑你得绕着走。作为用了两年多AI声音工具的编辑,我踩过的雷都给你列出来了:
别踩这个坑:在嘈杂环境录制样本。你以为AI能自动降噪?确实能,但降噪后的声音会损失细节,克隆出来"塑料感"很重。找个安静的房间,关上门窗,用手机录音都比在办公室强。
偷偷告诉你:样本文本要覆盖不同语气。别只念平铺直叙的说明文,,包含疑问句、感叹句、短句和长句。这样训练出来的声音模型,在讲课时才有起伏,不会一个调子到底。
说白了就是:声音复刻不是魔法,你给它什么素材,它就还你什么效果。样本质量决定了克隆质量,这是花再多钱也绕不过去的物理规律。
六、2026年,声音复刻将改变教师的创作方式
说句实在话,声音复刻是2026年教师内容创作领域最被低估的技术之一。它不像AI生成PPT那样热闹,也不像数字人那样吸睛,但它解决的是最实际、最磨人的问题——录音。
当你可以用自己的声音批量生产微课时,会发生什么?你会愿意做更多的微课,因为成本太低了。你会愿意尝试新的教学形式,因为试错成本几乎为零。你会愿意把知识分享出去,因为不再需要搭上周末的休息时间。
课件帮正在做的事情,就是把这些技术能力变成教师随手可用的工具。从声音复刻到数字人播报,从PPT转视频到全链路自动化,2026年的教师,真的可以"一个人活成一支内容团队"。如果你还在为录微课头疼,不妨试试声音复刻这条路。先花10分钟录个样本,然后感受一下"你的声音替你加班"是什么体验。
常见问题
-声音复刻需要录制多少样本?
课件帮声音复刻功能只需录制约10分钟的有效语音样本,系统即可完成声音模型训练。样本越清晰、环境越安静,克隆效果越自然。建议选择安静房间,用手机或电脑麦克风匀速朗读即可。
-克隆出来的声音自然吗?会不会有机械感?
2026年的声音复刻技术已经能捕捉语气、停顿和情绪起伏,课件帮的克隆声音在微课场景中自然度很高,学生基本听不出是AI配音。相比传统TTS(文本转语音),克隆声音保留了教师个人的发音习惯和语感,亲和力更强。
-用克隆声音生成的微课能商用吗?
课件帮的声音复刻功能仅用于教师本人内容创作,生成的微课可用于课堂教学、在线课程发布等非商业用途。若涉及商业授权或公开售卖课程,建议先确认平台版权政策,并保留声音授权记录。
-声音复刻支持哪些语言和方言?
课件帮声音复刻支持普通话、英语及常见方言(如粤语、四川话等)。训练样本使用什么语言,克隆声音就输出什么语言,适合双语微课或方言教学场景。
-声音复刻后如何批量生成微课?
在课件帮中完成声音克隆后,可直接将PPT导入系统,选择「PPT转视频」功能,系统会自动添加旁白、转场动画和背景音乐,全程使用你的克隆声音配音。一次训练,无限次使用,批量生成不同章节的微课只需替换PPT内容。