新讯网官方唯一联系电话:15001380073
阿里千问正式上线新一代原生全模态模型Qwen3.8-Omni-Flash。该模型支持文本、图像、音频和视频输入,具备1M长上下文,核心目标是推动全模态模型从“理解内容”走向“规划任务、调用工具并完成创作”。
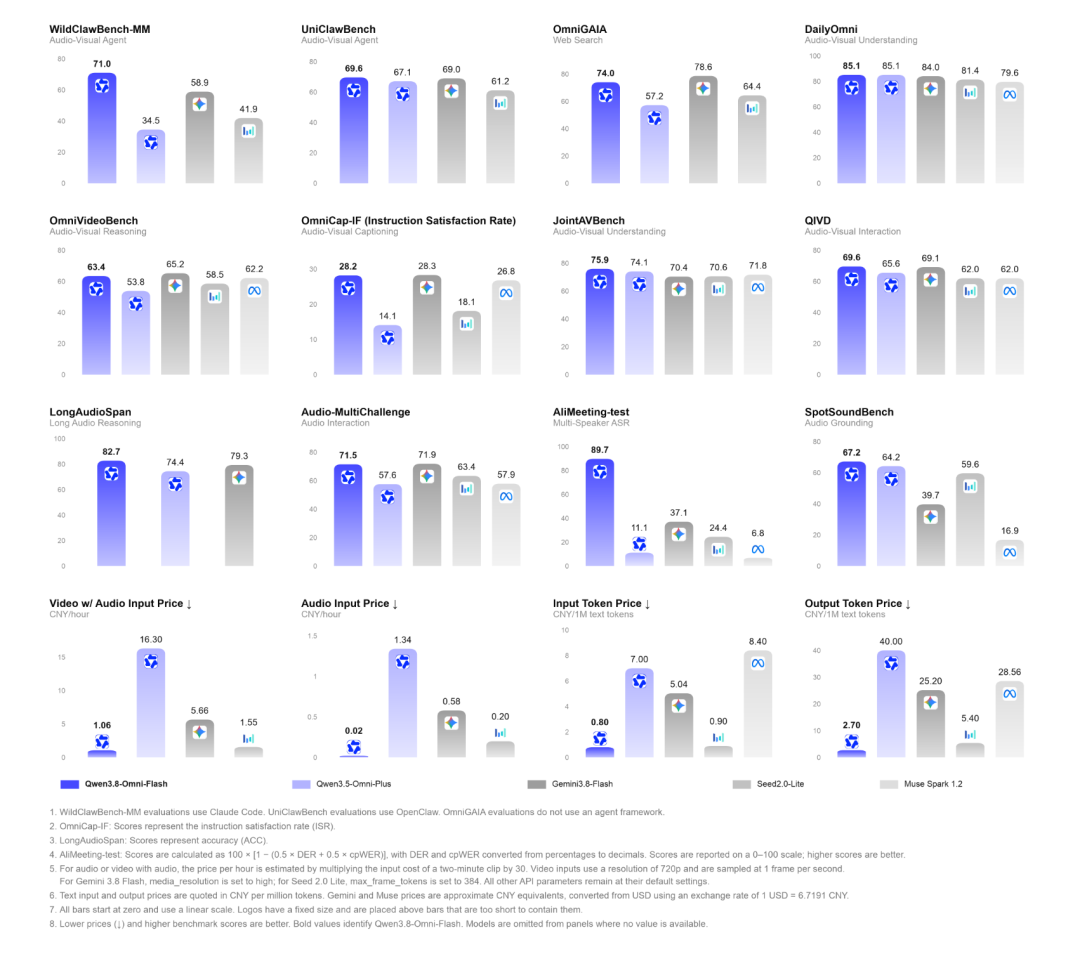
在累计30项评测中,该模型相比上一代Qwen3.5-Omni-Plus平均得分提升超26%。其中,音视频Agent、Coding及长程任务在WildClawBench-MM上提升36.5分,在AgenticVBench上提升22.3分,UniClawBench取得69.6分。音频能力整体超过Gemini 3.8 Flash,音视频能力接近该模型。
应用场景方面,模型可实现长音视频理解、会议纪要生成与任务执行、音乐视频创作、短剧翻译、长电影解说等端到端工作流。在“模型优化模型”实验中,Qwen3.8-Omni-Flash在12小时内将Qwen2.5-Omni-3B的四川话识别字符错误率从25.79%降至15.30%。
价格方面,该模型API每小时音频输入价格降幅超98%,每小时音视频输入价格降幅超93%。阿里同步开源Qwen-MM-Plugins与Qwen-Live Harness,分别面向长程工作流与实时交互。模型已上线千问AI平台。