新讯网官方唯一联系电话:15001380073
近几月,AI视频生成赛道持续升温。7月31日,Seedance 2.5与MiniMax H3同日发布;8月,阿里发布Wan3.0;进入9月,智象HiDream-O1-Video-1.0(下文简称HiDream V1)发布并冲上权威榜单全球前四。
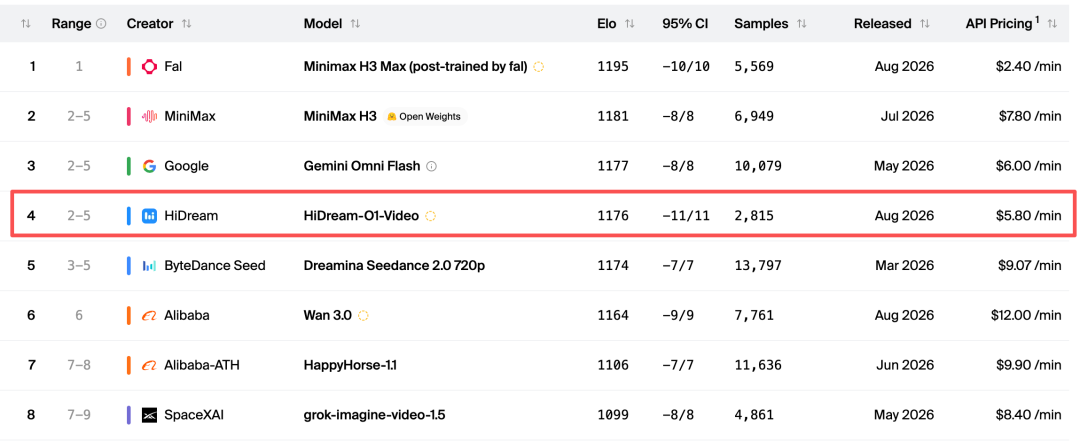
短短两个月,多家厂商接连推出新一代视频生成模型,行业竞争进一步加速。以字节Seedance、MiniMax H3、阿里Wan 3.0和智象HiDream V1为代表的中国模型,开始在全球主流榜单头部形成集群。中国视频生成模型正在从“单点领先”转向“多家并进”。
其中,智象作为创业公司进入这一竞争区间,也意味着全球视频模型的头部牌桌上,除了大厂和上市企业,开始出现新的玩家。
几轮密集上新的背后,AI视频生成也逐渐从单一的内容创作走向影视、广告、电商等诸多生产场景,与此同时,行业竞争的,也开始发生变化。
除了对画质、时长和人物一致性等方面的基础要求,模型对复杂运动、物理规律等真实世界的理解,正在成为新的竞争维度。随着视频模型开始处理越来越复杂的动作、空间关系和物理规律,视频生成也成为当前探索世界模型的重要路径之一。
9月15日,智象(HiDream.ai)发布了原生全模态音视频生成模型HiDream V1,其图生视频能力在Artificial Analysis排名第4,在Arena.ai的图生视频模型榜单中排名第8,双榜前十,跻身全球视频生成模型第一梯队。
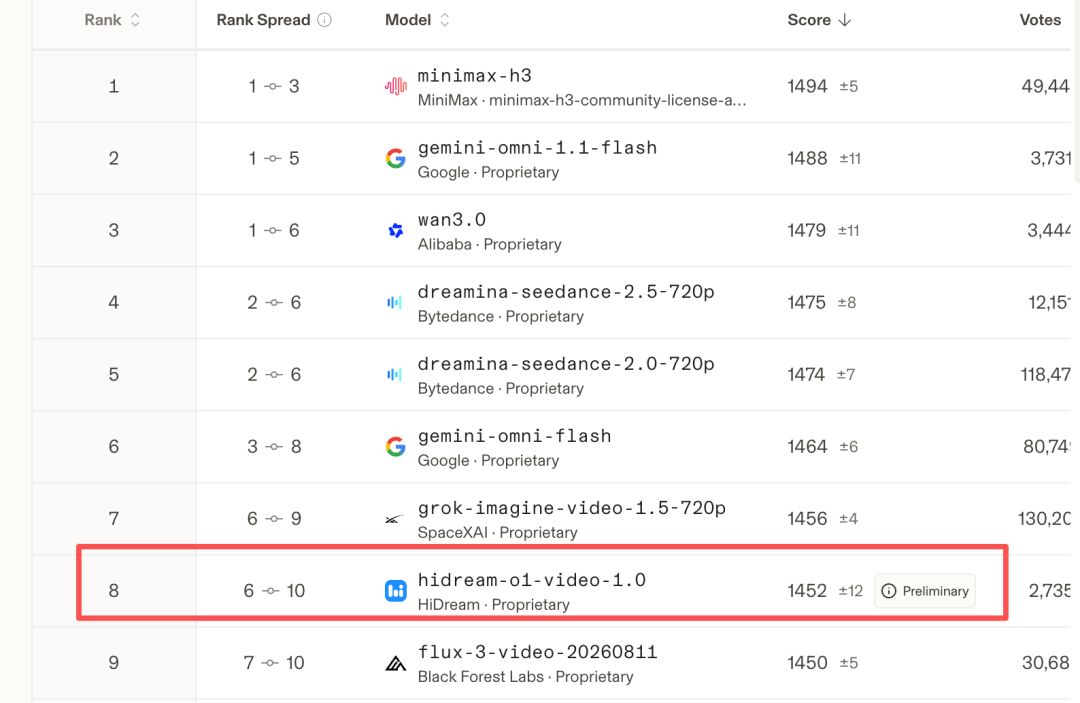
相比于榜单排名,更值得注意的是它的位置,从今年4月的HiDream-O1原生全模态架构算起,智象在图像、3D交互、具身方向的模型已相继落地,随着HiDream V1的加入,这套围绕世界模型路线构建的模型矩阵,也补上了视频这一块重要拼图。
这款模型的发布,不仅宣告了智象的原生全模态世界模型矩阵路线完成闭环,也在产业角度标志着智象正式跻身视频生成的核心决赛圈。
01.
听得懂人话,也敢不凑时长
现如今,人们使用视频生成工具的常规姿势,是把提示词写详尽:镜头、光线、动作、时长一项项交代清楚。但真实场景里,撰写专业提示词存在门槛,用户给模型的输入常常只是一句口语、一个模糊的念头。
在这种情况下,模型能否根据用户偏口语化、细碎、模糊的输入理解意图并生成视频,变得尤为重要。
HiDream V1的解法是,在生成前先通过多模态意图理解模块分析用户需求,再调用多模态理解模型进行结构化规划,规划字段覆盖人物、动作、镜头、光影、台词、声音等关键信息,将一句自然语言需求拆解成可执行的分镜信息后,再进入联合生成。
其中,时长也是规划的一部分。多数模型的生成时长由提示词预先设定:输入5秒,模型就在5秒窗口内完成内容,动作即使没有结束也只能压缩处理。
HiDream V1则让模型根据内容自行规划时长,结合事件展开、动作完成和叙事节奏决定生成长度,原生支持5—20秒任意时长生成。这样一来,时长不再只是固定参数,而会根据内容同步变化。
在此基础上,1080p高保真输出保障单镜头画质,为连续叙事提供基础。视频生成也由单纯的“按提示词生成画面”,进一步走向“理解用户意图后组织完整镜头”。
为了检验这套机制在真实输入下表现如何,智东西用三个场景做了实测。
首先来测试一下意图理解能力,我们用语音输入的方式提供了一段简单的提示词,并附上了一张从故事的中途切入的参考图,看看HiDream V1会怎样编排镜头。
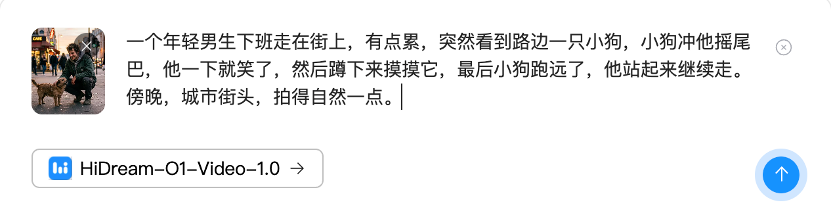
其实我们最终想要的就是抚摸小狗、小狗跑走,男生接着赶路这条线,同时,“下班”和“有点累”这两个关键词对主人公的状态存在约束。
能看到HiDream V1在生成视频时,根据参考图截取了故事情节,然后精确还原了人与狗的动向。同时在一些细节上,比如男生摸完狗以后手臂搭在腿上,起身时身体微微前倾和打晃等,透露出疲惫姿态。