新讯网官方唯一联系电话:15001380073
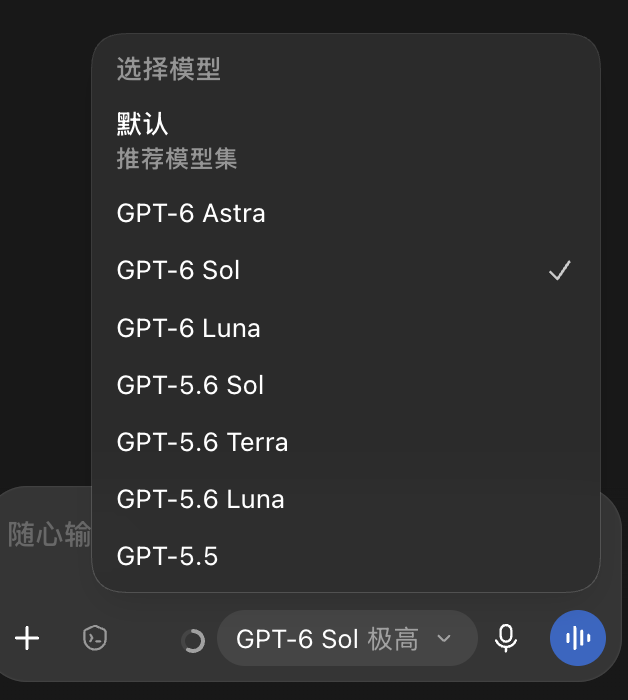
Astra改进的训练方法这两款也都用上了,所以也继承了Astra在计算机使用等方面的提升。
那还有啥好说的,等于5.6系列直接被斩杀了呗。

现在系列里Astra负责当以前的Sol,Sol负责当以前的Terra,Luna还是以前的Luna。
Terra生态位直接被挤没了。
与5.6系列相比,6系列的API定价直接砍50%,其中Luna的输出砍得比50%还多一点。
而且Luna的输入价格比DeepSeek-V4.1 Flash的梁文谷价格($0.15)还便宜一点了,就是不知道缓存命中率有没有的比。

为啥升级还便宜了?
OpenAI称这得益于缓存和推理环节的效率提升,省下来的成本直接让利给用户和,。

这不得尊奥特曼一声奥特,(限时24小时)。
用一成价格,盯着Fable打
整个发布公告看下来,我先学会一招,用GPT-6 Sol,别开Max。
效果提升有限,价格提升很大,就不如直接开Astra了,还有个别榜单跑分Max比xHigh掉分。
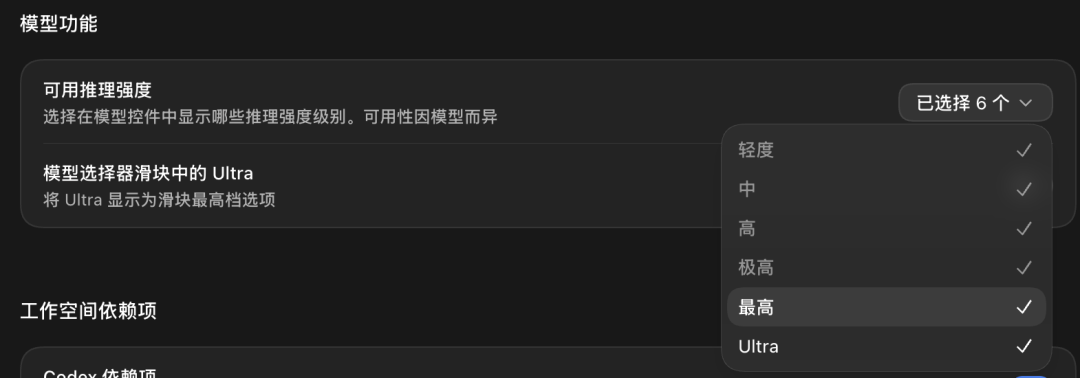
什么你不知道怎么在Codex里开Max?
在设置里可以选,默认是没打开的,这下知道为什么没打开了。
按照AutomationBench这个榜,GPT-6 Sol的high和xhigh两个档位已经摸到了Astra的light和medium的水平。
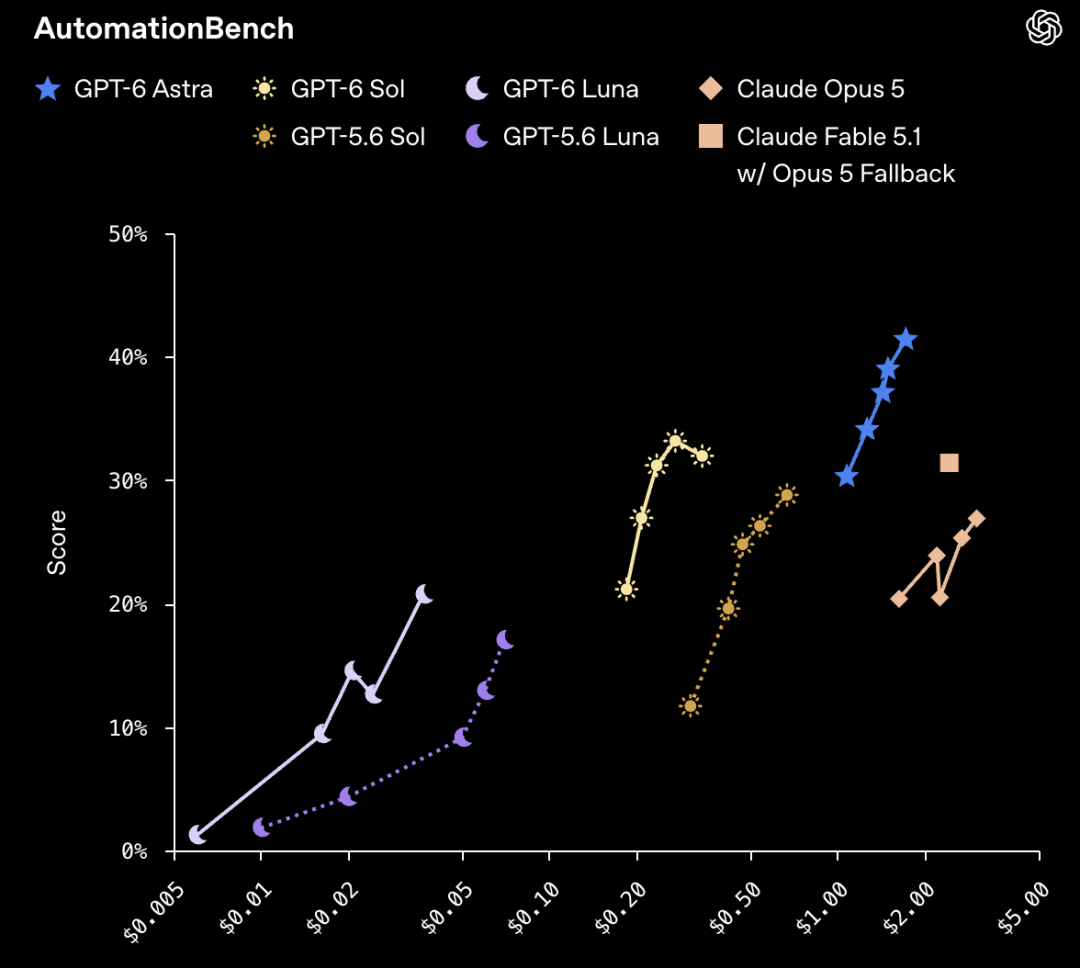
AutomationBench测的是AI在销售、营销、运营、客服、财务和人力资源六大领域47个工具上执行端到端业务流程的能力。
作为对比,Claude Opus 5在max effort下得分和GPT-6 Sol的medium差不多,但单任务成本是Sol的11.1倍。
Claude Fable 5.1,成本是Sol的8.9倍以上,而且这还没算上约40%任务触发Opus 5回退产生的额外开销。
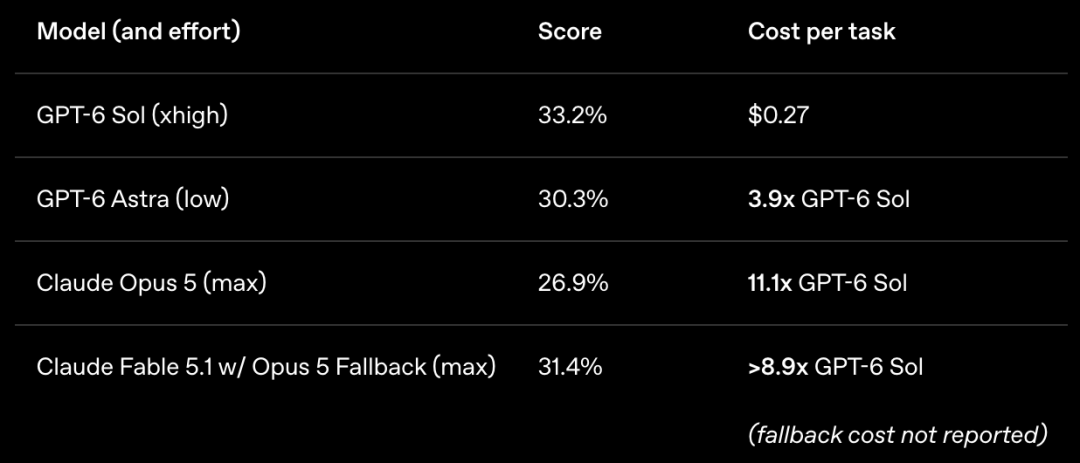
为测试GPT-6 Sol的计算机使用能力,我让它在图表中把隔壁新发的Opus5.5成绩也画上去。
这下可以直观看出,Opus5.5的Max档达到了GPT-6 Astra水平,价格也达到了Astra水平。

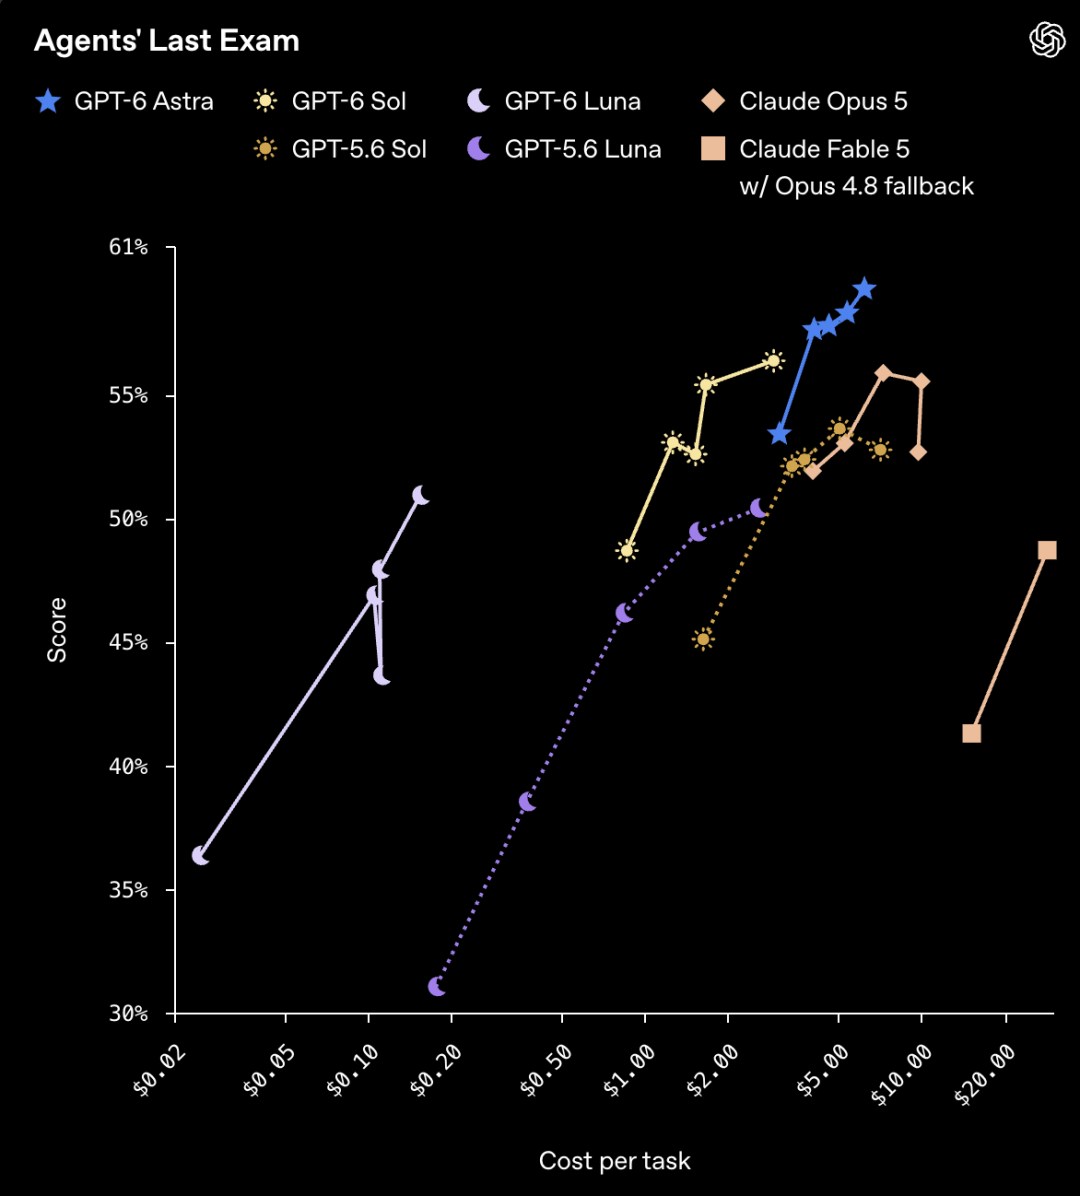
换Agents' Last Exam,这次考长周期任务,覆盖55个子行业。
GPT-6 Sol在max effort下得分56.4%,超过Claude Opus 5在该测试中的,分,成本还低了60%。
编程是这次,展示的方向。
OpenAI透露了一组内部数据:公司内部的Coding Agent使用量呈指数级增长,按API价格折算,中位数研究员每天的token消耗已超过600美元,90分位的研究员超过7000美元。
随着编程agent承担的任务越来越长、越来越复杂,持续使用的成本变得更加关键,这正是Sol和Luna要解决的问题。
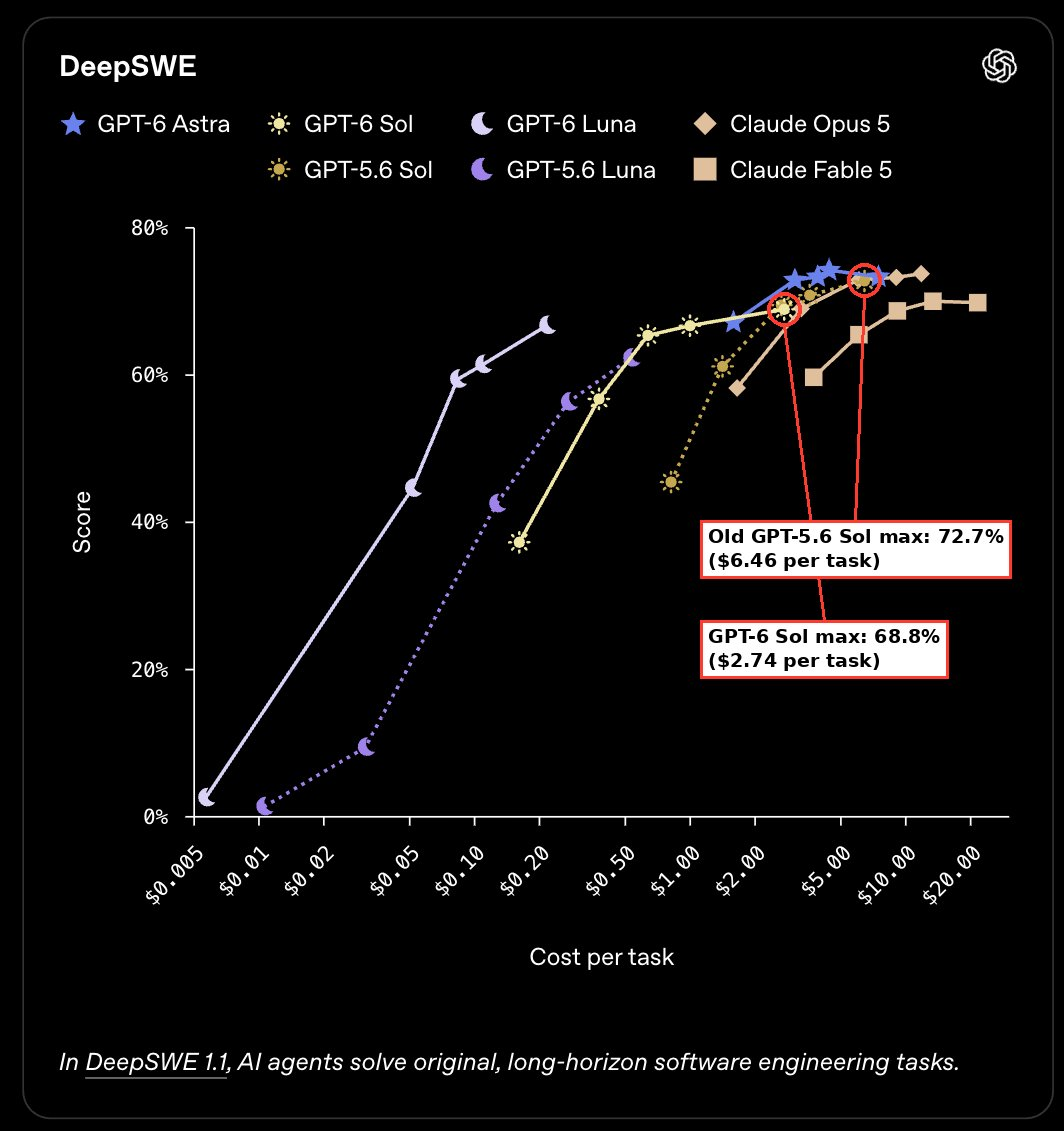
在DeepSWE v1.1(测试AI在真实代码库中解决复杂软件工程任务)上,GPT-6 Sol其实并没有比5.6 Sol更好,但确实便宜不少。
GPT-6 Luna在max effort下得分66.6%,与Claude Opus 5和Fable 5在medium effort下水平相当,成本分别低了93%和96%。
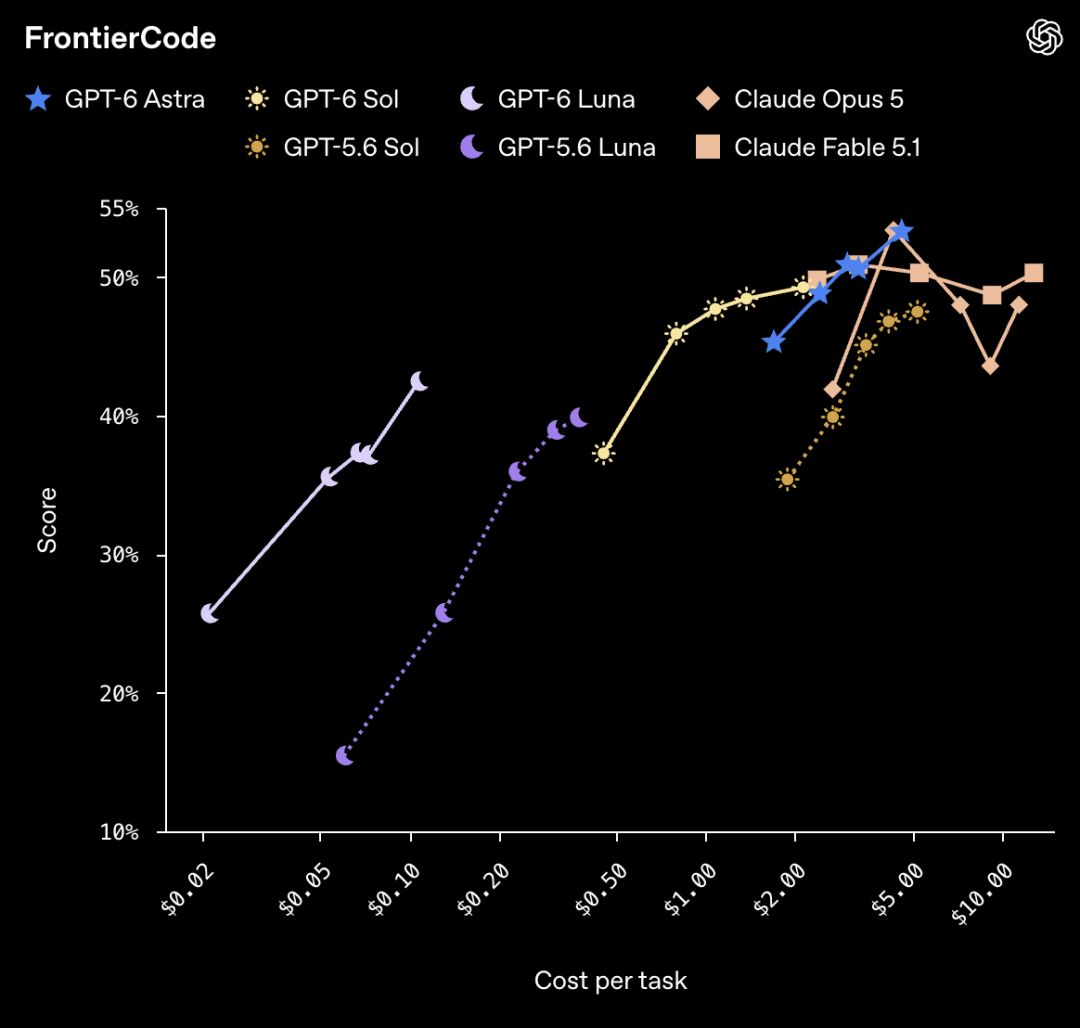
在Cognition推出的FrontierCode(评估AI编写的代码是否达到可合并进真实代码库的标准)上,GPT-6 Sol相比GPT-5.6 Sol同样有明显提升,能以更低成本匹配Claude Fable 5.1 xhigh的表现。
这个榜隔壁Claude的档位又乱了起来。
计算机操作,这块还是Astra比较权威。
GPT-6 Sol也仅仅是比5.6 Sol便宜了,high档位以上水平其实没超过5.6多少。
GPT-6 Luna在max effort下超过了GPT-5.6 Sol在medium effort下的表现,成本仅为后者的十分之一。

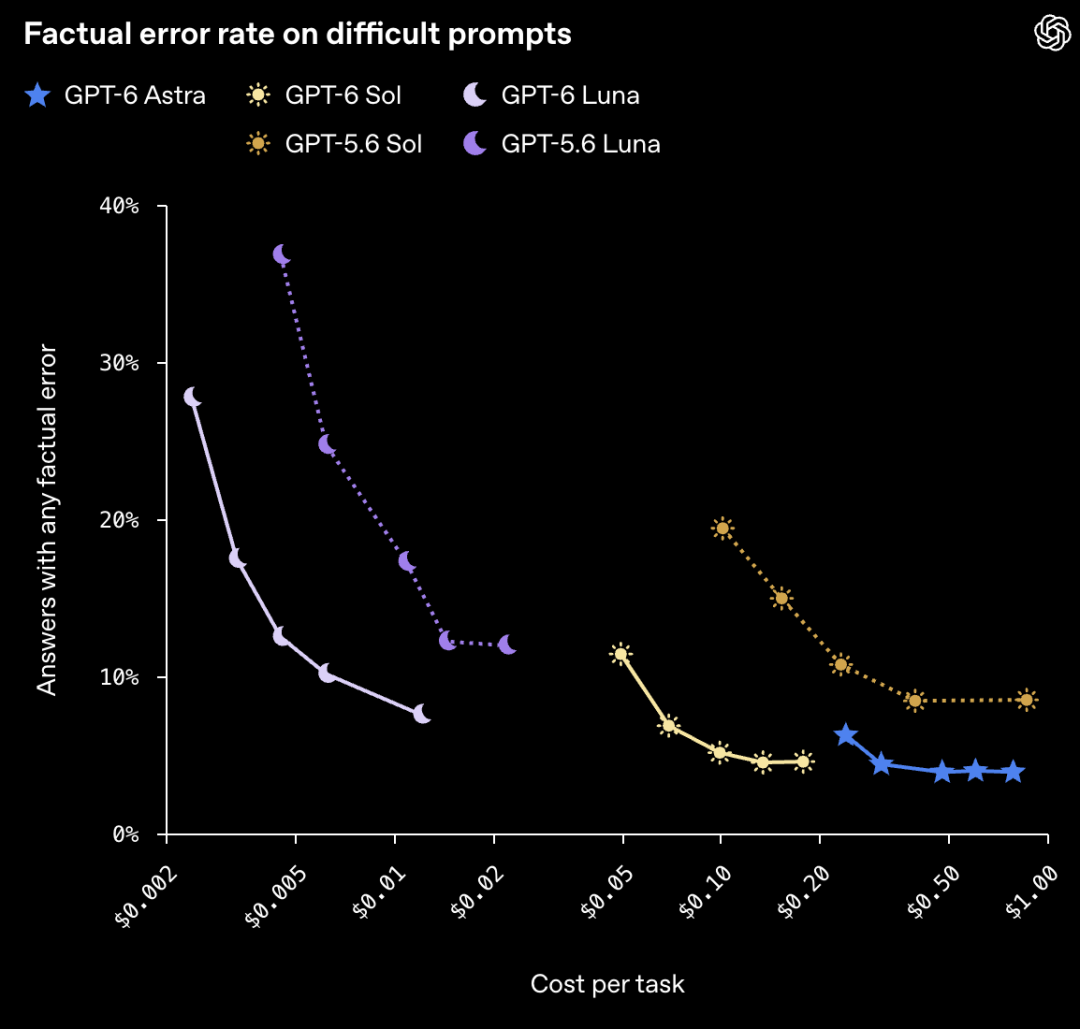
事实准确性方面,OpenAI用一组从真实ChatGPT对话中提取的、用户曾标记过事实错误的案例进行了测试。
结果是GPT-6 Sol的错误率大约是上一代的一半,接近Astra的水平。GPT-6 Luna在较高effort下能匹配GPT-5.6 Sol的准确度,而成本只有百分之一。
缓存命中率提升,重置马上来
模型能力之外,OpenAI对GPT-6的基础设施也做了几项改进。
首先是提示词缓存。
改进后的缓存机制默认提供更高的命中率,缓存命中的输入token可享受90%的价格折扣。
OpenAI还上线了缓存监控面板和诊断工具,,可以查看缓存使用情况、定位未命中的原因并针对性优化。
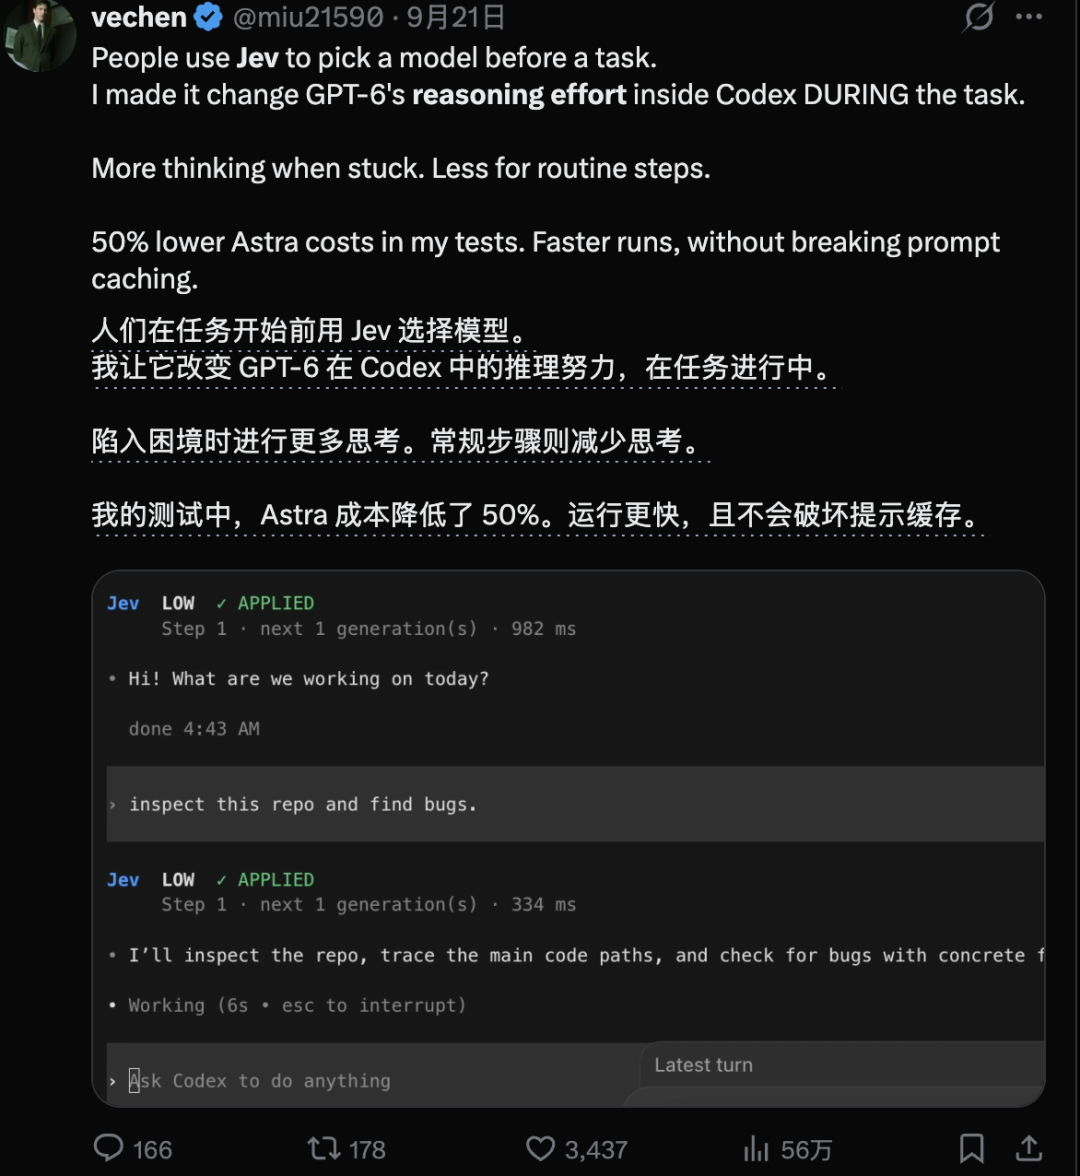
还有这样一个实用的改动:调整推理effort级别或开关工具时,不再会打断之前的缓存上下文。
GitHub已经在用这套方案。据OpenAI披露,过去几个月里这些优化让GitHub Copilot需要重新处理的提示token比例下降了超过50%,涉及数十亿次请求。
终于能在任务的不同任务灵活切换配置了。
之前看已经有人做出来,搭配Jev可以在任务中途毫秒级切换。
然后是对话风格。
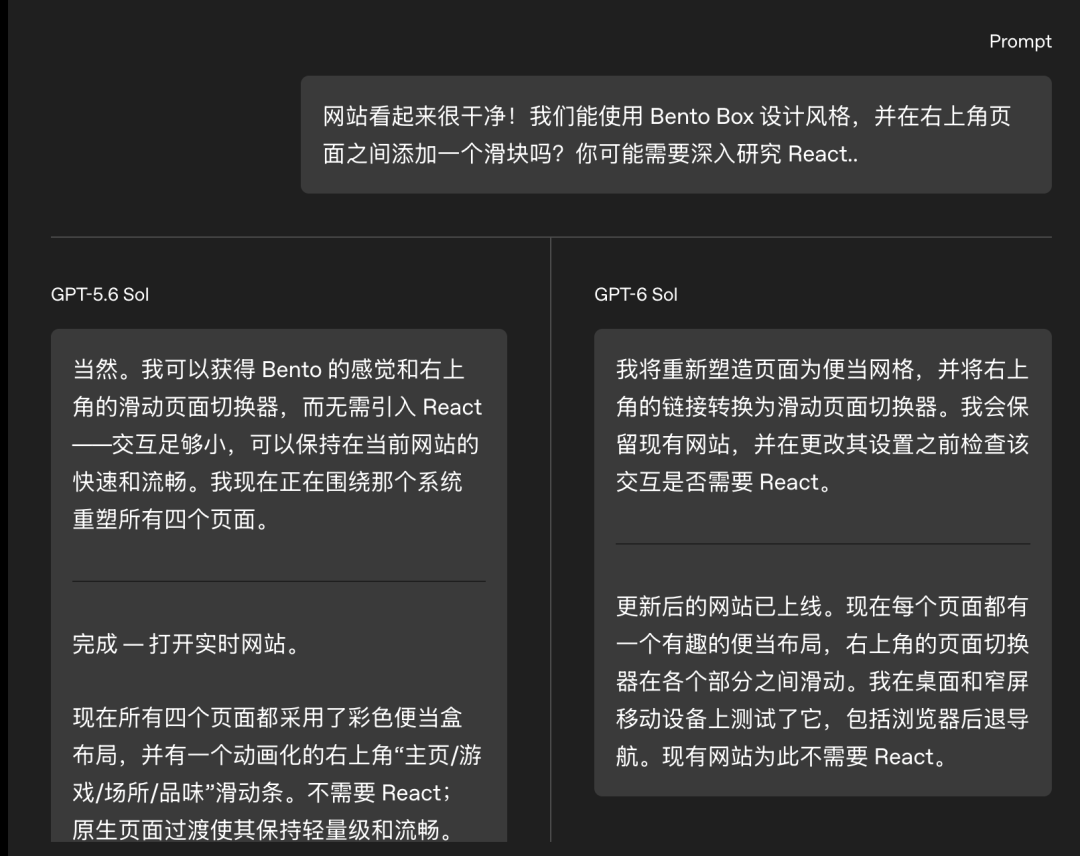
OpenAI把Astra上改进过的沟通方式带到了Sol和Luna上,在技术和编程对话中感知会尤为明显,表现为更清晰、更少术语、更少无效细节、回复整体更简短但不丢失关键信息。
OpenAI在博客中展示了同一个网页开发任务下GPT-5.6 Sol和GPT-6 Sol的对比回复。
5.6会主动复述用户已知的信息并使用含糊措辞,6则更直接,会说明自己检查了什么、没检查什么。
对齐方面,Sol和Luna在测试中优于GPT-5.6同级模型,包括在编程任务中做出误导性声明的比率更低。OpenAI强调,这些对齐测试专门挑选了容易诱发不诚实行为的场景,正常使用中出现此类问题的概率远低于测试数据。
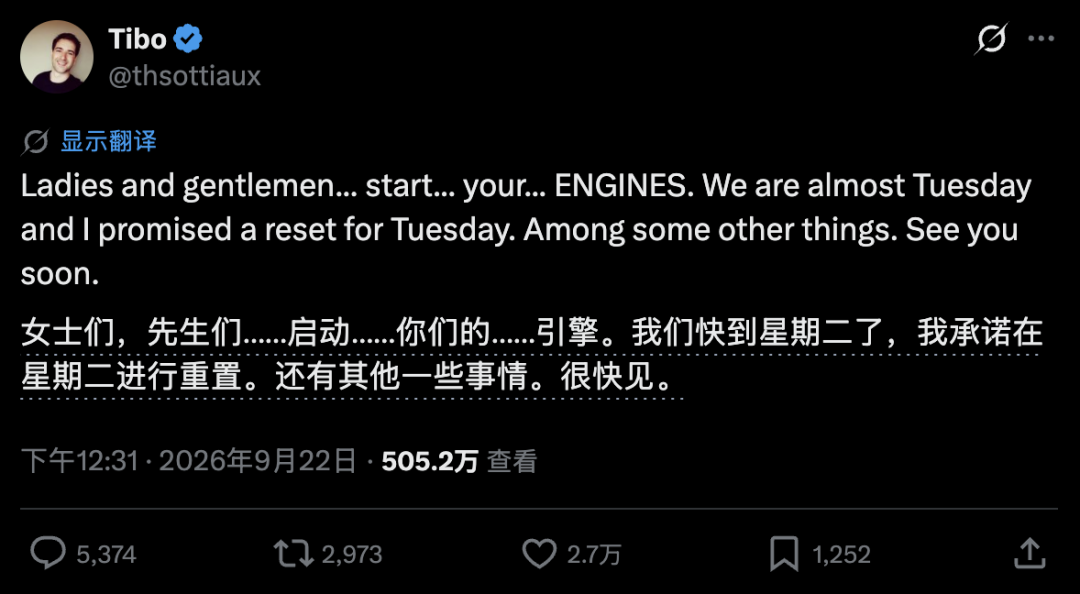
,,关于额度重置。
总之是周二,具体时间未定,醒来的朋友们可以开蹬了。
参考链接:
[1]https://openai.com/index/introducing-gpt-6-sol-and-luna/#alignment-reviewer-bypass
[2]https://x.com/miu21590/status/2101857866378362926?s=20